Sora est mort le 24 septembre. La vidéo n'avait pas besoin d'un TikTok, elle avait besoin d'une histoire
OpenAI a coupé l'API Sora le 24 septembre. Un flux de vidéos générées n'a pas de sujet. Ce que mes joueurs demandent vraiment, chiffres de prod à l'appui.
par Yannis Achour10 min de lecture
Sommaire
Le 24 septembre, OpenAI a éteint l'API de Sora. L'app, elle, avait fermé fin avril. C'est la fin de la marque, pas du modèle : Sora 2 reste dans ChatGPT pour les abonnés. OpenAI n'a pas parlé d'argent. Un porte-parole a expliqué que l'équipe partait travailler sur la simulation du monde, pour la robotique. Garde cette phrase en tête, on y revient à la fin.
L'argent, c'est la presse qui en a parlé. Le Wall Street Journal, fin mars : environ un million de dollars de pertes par jour, selon une source interne. Appfigures : 2,1 millions de dollars d'achats in-app, en tout, depuis le lancement. Un pic à 3,3 millions de téléchargements en novembre 2025, le mois où l'app arrive sur Android, puis 1,1 million en février. Côté utilisateurs, un pic autour d'un million, puis moins de 500 000. Disney avait annoncé un milliard d'investissement dans OpenAI, avec deux cents personnages sous licence pour Sora. Le deal n'a jamais été signé : Disney a appris la fermeture moins d'une heure avant l'annonce publique, et s'est retiré.
Je ne m'en moque pas. Sora 2, sorti le 30 septembre 2025, c'était ce que j'attendais depuis des années : de la vidéo cohérente, avec le son synchronisé, à partir d'une phrase. Ma première pensée : des artistes allaient s'en emparer et sortir des choses dingues, uniques, drôles. Puis je l'ai testé. Plusieurs minutes d'attente par clip, un prix qui fait hésiter avant chaque essai, et mon envie d'explorer n'a pas tenu. Visiblement, je n'étais pas le seul.
Et plus les chiffres sortaient, plus une idée s'installait. L'attente et le prix, le progrès les règle ; on l'a vu dès cet été. Ce qui a tué Sora est ailleurs : un flux de vidéos générées n'a pas de sujet.
Un flux n'a pas de mémoire
Sora, l'app, c'était TikTok avec des vidéos inventées. Un chat astronaute, ton pote en samouraï, on rit, on scrolle. La vidéo suivante n'a aucun rapport avec la précédente, et aucune ne se souvient de rien. Dix secondes de spectacle, puis plus rien.
Ça tient trois semaines. Un meme a besoin d'un contexte partagé pour être drôle ; une vidéo inventée de toutes pièces n'en a aucun. Le « wow » des premiers jours, c'était celui du modèle. On l'a tous vécu avec chaque génération de modèle d'image depuis 2022 : il s'use en une semaine.
Ma thèse tient en une phrase. Une vidéo générée n'a de valeur que si elle a un avant : un personnage qu'on connaît, un lieu où on est déjà allé, un objet dont on sait d'où il vient. Il lui faut une mémoire, et ce n'est pas le modèle vidéo qui la fournit.
Plus vite que la lecture
L'été a été rapide. MiniMax sort H3 le 31 juillet : de la vidéo avec son stéréo, jusqu'à quinze secondes. Fin août, fal en publie une version post-entraînée, H3 Max, puis une version Turbo mi-septembre ; c'est celle que j'utilise pour animer les scènes de dialogue. Le 1er septembre, vLLM montre FastH3 : dix secondes de vidéo avec le son, rendues en 8,7 secondes. Sur huit GPU B300, mais quand même. Le seuil symbolique est passé : on génère plus vite qu'on ne regarde.
Ce n'est pas encore du temps réel au sens d'un flux qui réagit pendant qu'il joue. Meta s'en approche : à Connect, le 23 septembre, Muse a annoncé un avatar avec lequel on pourra discuter en vidéo, environ 870 millisecondes de latence. « Bientôt », sans date.
J'ai passé une bonne partie de la semaine à me demander ce que ça change pour un jeu comme le mien. Réponse provisoire : ça enlève l'attente, et c'est à peu près tout.
Ce qui reste dur, c'est la cohérence dans le temps. Dix secondes générées en dix secondes, génial. Dix autres secondes où la même femme a les mêmes yeux, la même cicatrice, le manteau qu'elle a échangé contre une cape au chapitre 3 : autre affaire. Et une heure plus tard, le colporteur qui a reçu la clochette de laiton doit la porter à sa ceinture, alors que personne n'a écrit « colporteur avec clochette » dans le prompt. Le modèle vidéo n'en sait rien. L'histoire, si.
C'est ce que j'ai passé deux fois quatre-vingt-dix jours à mesurer sur le texte, et j'en ai raconté les galères ici. Le texte, c'est le cas facile. Un nom inventé qui doit revenir mot pour mot après trois mois, j'y ai laissé des nuits. Un visage inventé qui doit revenir trait pour trait, sur un modèle qui ne l'a jamais vu, c'est le même problème en beaucoup plus cher.
Ce que j'observe chez moi
Le narrateur de Miraviel écrit du texte. Quand une scène le mérite, un LLM rapide en tire un prompt et un modèle d'image rapide la dessine. Par défaut, seules les scènes clés sont illustrées : une arrivée, un personnage qui change d'apparence, un changement d'ambiance. La voix et la vidéo sont à un tap, jamais automatiques.
J'étais parti pour écrire que les joueurs ne demandent pas de vidéo. Puis j'ai ouvert le journal des coûts.
Depuis le 18 septembre, date des réglages actuels, 104 joueurs ont joué 2 595 tours (mon compte et les comptes de test exclus). 41 d'entre eux ont demandé au moins un clip. 39 %. La vidéo, c'est 38 % de ce qu'ils coûtent, plus que le texte (35 %) et que les images (23 %).
Donc si, ils en veulent. La question intéressante, c'est quand.
Les joueurs ne veulent pas un clip au hasard. Ils le demandent quand il y a un avant.
Les prix disent la même chose, dans l'autre sens :
| Unité | Coût | En tours de narrateur |
|---|---|---|
| Un tour de narrateur | 0,0042 $ | 1 |
| Un tour complet (narrateur, mise en scène, état du monde) | 0,0124 $ | ≈ 3 |
| Une image (contrôle de sécurité compris) | 0,0038 $ | ≈ 1 |
| Un clip vidéo, moyenne des moteurs | 0,129 $ | ≈ 30 |
| Un clip H3 de 5 secondes | 0,20 $ | ≈ 48 |
Une image coûte à peu près un tour de narrateur. Un clip en coûte trente. Mon run de re-certification de 90 jours, c'est 540 messages et 2 239 scènes ; le narrateur y lisait environ 19 000 tokens par message, dont 57 % venaient du cache. Aux prix d'aujourd'hui, le texte de ce run coûte environ 7 $, les images des scènes clés environ 4 $. Une vidéo par scène : autour de 290 $. Personne ne paiera ça pour une histoire, et je doute que quelqu'un le veuille.
Et puis il y a ce retour, reçu le 23 septembre. Je le cite en entier, parce que la première phrase compte autant que la seconde :
« This is the best visualisation of any CYOA game I've ever seen. […] even without the image and video gen, reserving it for the map generation and rare story-beats, this would be insanely popular. »
« La meilleure mise en images de tous les jeux dont vous êtes le héros que j'aie vus. […] Même sans génération d'images ni de vidéo, en la réservant à la génération de cartes et aux rares moments clés de l'histoire, ce serait insanely popular. »
Le même joueur trouve les images formidables et dit qu'on pourrait presque s'en passer. Je ne crois pas qu'il se contredise. Il dit qu'il veut voir son histoire aux moments où elle compte. Une image toutes les six scènes, c'est du bruit. Une image quand la foudre fend le poirier et que la tasse verte fêlée est sur la table, c'est un souvenir. Et pour savoir quel moment compte, il faut une mémoire qui sache ce qui a changé.
Les quatorze images de mon article précédent ont été générées après coup, sur les scènes réelles du run, par la chaîne du jeu : 0,05 $. Quatorze images pour quatre-vingt-dix jours d'histoire. C'est à peu près le ratio d'une mémoire : quelques images nettes, beaucoup de texte autour.
2029, une histoire qui se filme
Voilà où je crois que ça va. C'est une extrapolation, je n'ai trouvé aucune projection sérieuse à citer.
Mi-2025, dix secondes de Veo 3 coûtaient environ 7,50 $ en API. En septembre 2026, dix secondes de H3 Max en 768p coûtent environ 0,40 $. Vingt fois moins en quinze mois, à qualité pas tout à fait comparable. Chez moi, un clip coûte encore entre trente et cinquante fois une image. Au rythme actuel, l'écart se referme vers 2028 ou 2029. Les modèles de monde avancent en parallèle : World Labs a présenté Atlas en septembre, ByteDance préparerait un modèle de monde temps réel pour octobre, selon Bloomberg. Et OpenAI, on l'a vu, y envoie l'équipe de Sora.
Le rendu ne sera plus le goulot. Le goulot, ce sera ce que le rendu doit savoir. À chaque plan, une histoire qui se filme doit répondre à quelques questions : qui est là, à quoi il ressemble aujourd'hui (pas au chapitre 1), ce qu'il y a dans la pièce et ce qui n'y est plus, qui sait quoi. Ce sont, à peu de chose près, les dimensions que je teste sur le texte. La vidéo en augmente juste le prix.
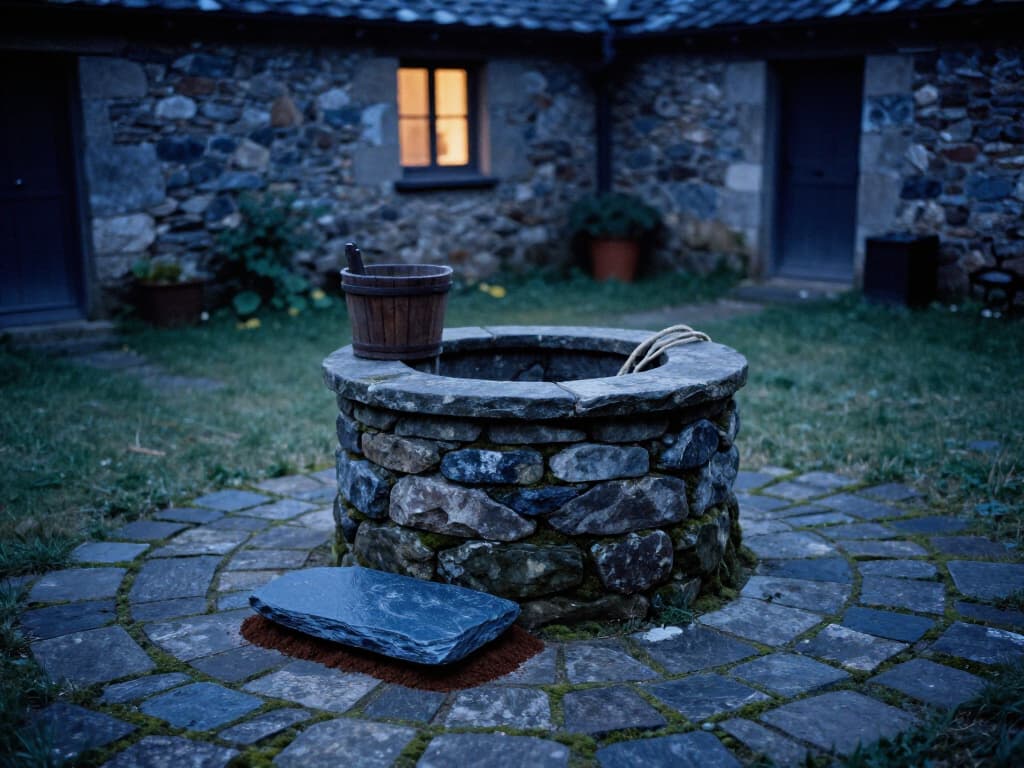
La scène que j'imagine : tu reviens dans une histoire commencée il y a quatre mois. Premier plan, avant que tu écrives quoi que ce soit : le puits, et la dalle bleue légèrement déplacée. Personne n'explique rien. Toi seul sais ce qu'il y a dessous. L'histoire s'est souvenue d'un truc que tu as fait sans témoin, et elle te le montre sans le dire. C'est la réminiscence par le lieu, en image. En texte, c'est justement la dimension où j'échoue encore : une sonde sur sept a fait surface sur mon dernier run complet. En vidéo, c'est le test qui départagera tout le monde.
Ce qui casse, d'abord : le faux souvenir en image. En texte, un narrateur qui invente un nom (Eldric, chez moi) produit un faux souvenir que la consolidation enregistre ensuite comme vrai. Je l'ai mesuré, puis corrigé. En vidéo, le modèle invente tout le temps : chaque plan est une reconstruction, chaque visage une approximation. Si la mémoire se met à apprendre de ses propres images, elle apprend des hallucinations par milliers. Une histoire qui se filme doit se souvenir de ce qui s'est passé, pas de ce qu'elle a montré. Je ne connais personne qui ait résolu ça, moi compris.
Ensuite : le flux revient par la fenêtre. Dès que la vidéo ne coûte plus rien, la tentation est de tout montrer, et on refait Sora, à l'intérieur d'une histoire cette fois. Le garde-fou n'est pas technique, c'est un choix d'auteur : ne montrer que ce qui a un avant.
Ce que je ne sais pas
Je ne sais pas si les joueurs de RP voudront de la vidéo partout. Le texte a un avantage que je sous-estime souvent : le lecteur fait le rendu dans sa tête, et il ne se trompe jamais sur le visage du personnage, puisque c'est le sien. Mes chiffres disent qu'ils en veulent par moments. Pas qu'ils en veulent tout le temps.
Je ne sais pas mesurer la cohérence visuelle dans le temps. Mon protocole de mémoire a des sondes pour le texte ; je n'ai rien qui dise « ce visage est le même qu'il y a trente jours ». Aujourd'hui, j'ai des LoRA de personnages : ça tient un visage, au prix de la variété, et deux LoRA dans la même image se mélangent encore. C'est sans doute la prochaine dimension à ajouter. Je n'ai pas la méthode.
Et je ne sais pas si Sora est un contre-exemple ou un précurseur. OpenAI a peut-être simplement lâché un produit trop cher pour se concentrer sur l'entreprise et la productivité ; c'est ce que rapportait le WSJ en mars. Ce qui est sûr, c'est que le prochain qui voudra vendre de la vidéo générée au grand public devra répondre à une question que Sora ne s'est jamais posée : de quoi cette vidéo est-elle le souvenir ?
Questions fréquentes
Pourquoi OpenAI a-t-il arrêté Sora ?
OpenAI n'a pas donné de raison financière. Un porte-parole a dit que l'équipe se tournait vers la recherche en simulation du monde pour la robotique. Selon le WSJ, l'app perdait environ un million de dollars par jour ; selon Appfigures, elle a rapporté 2,1 millions de dollars d'achats in-app en tout.
La vidéo « plus rapide que la lecture » change-t-elle quelque chose pour la fiction interactive ?
Elle enlève l'attente. Elle ne dit pas au modèle qui est dans la pièce, ce que porte le personnage aujourd'hui ni ce qui a disparu depuis hier. Ça, c'est la mémoire du récit qui le sait.
Miraviel génère-t-il une vidéo à chaque scène ?
Non. Par défaut, seules les scènes clés sont illustrées, et la vidéo comme la voix sont à un tap. Depuis le 18 septembre, 39 % des joueurs ont demandé au moins un clip, en moyenne au bout de plusieurs tours d'histoire.
Sources
- 01What to know about the Sora discontinuation — OpenAI Help Center — help.openai.com, 24 septembre 2026
- 02Sora 2 is here — OpenAI — openai.com, 30 septembre 2025
- 03OpenAI's Sora was the creepiest app on your phone. Now it's shutting down — TechCrunch — techcrunch.com, 24 mars 2026
- 04The sudden fall of OpenAI's most hyped product since ChatGPT — The Wall Street Journal — wsj.com, 29 mars 2026
- 05OpenAI's Sora app is struggling after its stellar launch (données Appfigures) — TechCrunch — techcrunch.com, 29 janvier 2026
- 06Sora shut down, Disney investment off — Deadline — deadline.com, 24 mars 2026
- 07OpenAI to cut back on side projects to focus on core business, WSJ reports — Reuters — tradingview.com, 16 mars 2026
- 08MiniMax H3 — MiniMax — minimax.io, 31 juillet 2026
- 09Introducing H3 Max — fal — blog.fal.ai, 27 août 2026
- 10Serving MiniMax H3 in production (FastH3) — vLLM — vllm.ai, 1 septembre 2026
- 11Everything new coming to Meta's AI agent Muse — TechCrunch — techcrunch.com, 23 septembre 2026
- 12ByteDance founder joins AI elite in race to perfect world models — Bloomberg — bloomberg.com, 7 septembre 2026
- 13Veo 3 and Veo 3 Fast: new pricing — Google for Developers — developers.googleblog.com, 8 septembre 2025
- 14How we test memory (documentation technique) — miraviel.app, 2 septembre 2026
Cet article est traduit de l'anglais. La version anglaise est la version de référence. Lire cet article en anglais →